تكتب سؤالًا في جوجل وتضغط «بحث»، فتصلك عشر نتائج في أقلّ من ثانية. في تلك اللحظة لم يخرج جوجل إلى الإنترنت ليبحث عن جوابك، فالويب أكبر من أن يُقرأ في جزءٍ من ثانية. ما فعله أنّه بحث في نسخةٍ منظّمةٍ من الويب بناها قبل سؤالك بأيّامٍ وأسابيع، وهي «الفهرس» الذي تقول جوجل إنّه يغطّي مئات المليارات من الصفحات ويتجاوز مئة مليون جيجابايت.[1]
كيف تدخل صفحتك تلك النسخة، وكيف تُختار من بين ملايين الصفحات لتظهر أمام سائلٍ بعينه، هو السؤال الذي يقوم عليه السيو كلّه. في هذا المقال أتتبّع رحلة صفحةٍ واحدة من لحظة نشرها إلى لحظة ظهورها، مرحلةً مرحلة، مع ما تستطيع أنت فعله عند كلّ باب، وما لا تستطيع.
محرّك البحث: عملٌ طويل قبل سؤالك، وعملٌ قصيرٌ بعده
محرّك البحث برنامجٌ يعمل على زمنين منفصلين. في الزمن الأوّل، وهو مستمرّ لا يتوقّف، يجوب الويب ويقرأ صفحاته ويخزّن ما فهمه منها، وفي الزمن الثاني، الذي يبدأ حين تضغط «بحث»، يفتّش ما خزّنه ويرتّب ما وجده. كلّ ما تراه من سرعةٍ في النتائج ثمرة الزمن الأوّل.
تخيّل أمين مكتبةٍ ضخمة قرأ كلّ كتابٍ حين وصل، وكتب له بطاقةً في فهرسٍ مرتّب، فحين تسأله عن موضوعٍ يفتح البطاقات فيدلّك على الرفّ في ثوانٍ. ويقف التشبيه عند حدّه في موضعين: المكتبة لا يضاف إليها كلّ يومٍ ملايين الكتب، وأمين المكتبة لا يرتّب لك الكتب بحسب ما يظنّ أنّه يفيدك أنت تحديدًا، وجوجل يفعل الأمرين.
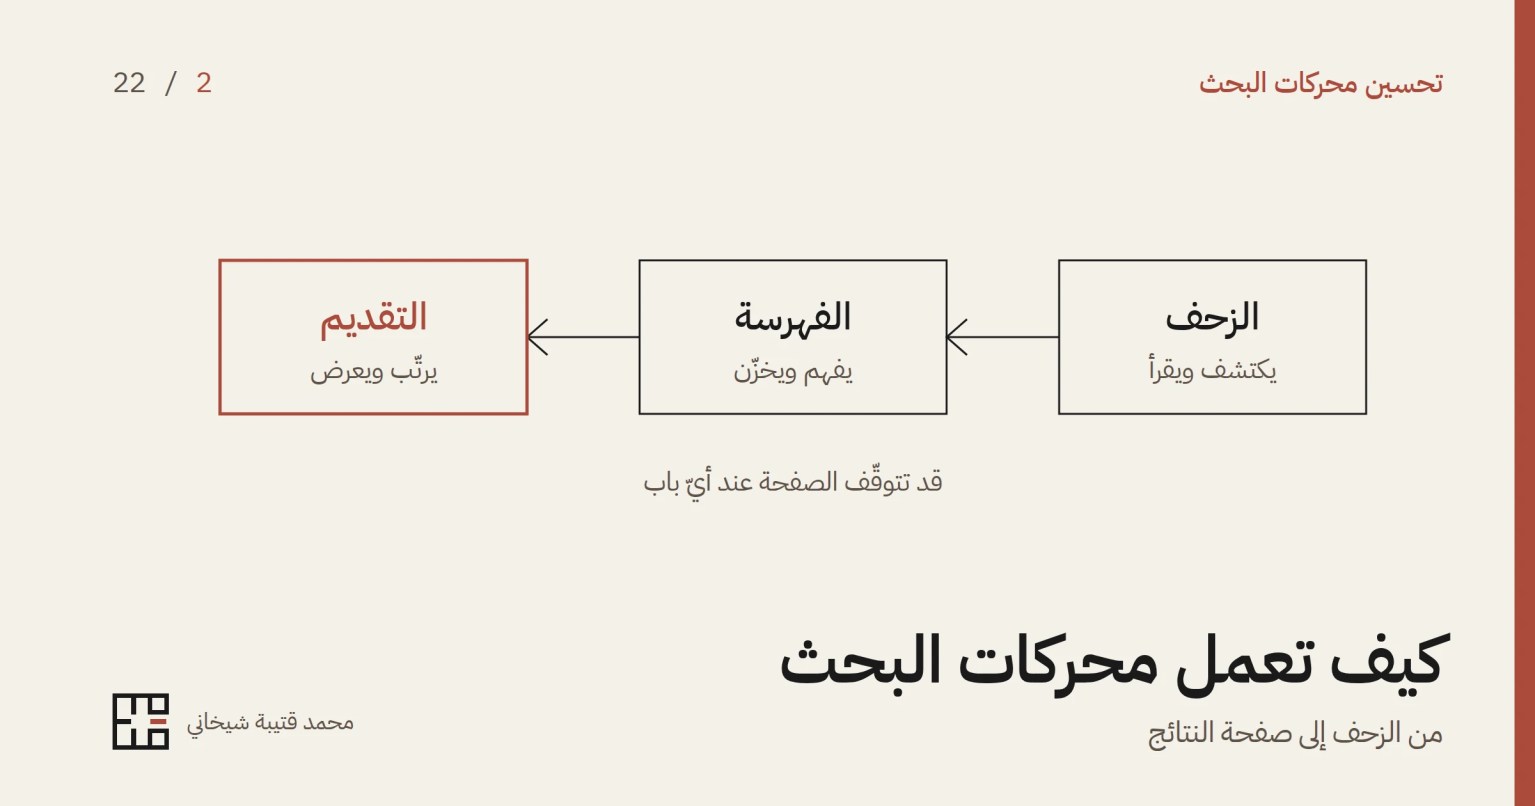
وتقسم جوجل عملها رسميًّا إلى ثلاث مراحل: الزحف (Crawling)، ثمّ الفهرسة (Indexing)، ثمّ تقديم النتائج (Serving)، وفيه يقع الترتيب. وتقول في الموضع نفسه إنّ الصفحات لا تعبر المراحل الثلاث كلّها، وإنّها لا تضمن أن تزحف إلى صفحتك أو تفهرسها أو تعرضها، حتى لو التزمت إرشاداتها.[2] كثيرٌ من المقالات العربية تذكر أربع مراحل بفصل الترتيب عن التقديم، وهو تبسيطٌ مقبول، لكنّني ألتزم هنا تقسيم جوجل نفسها. والشكل 1 يجمع المراحل الثلاث وما تملكه أنت في كلٍّ منها.
المرحلة الأولى: الزحف
الزحف اكتشاف الصفحات وتنزيلها. عند جوجل برنامجٌ يُسمّى Googlebot يبدأ من صفحاتٍ يعرفها، ويتتبّع الروابط التي فيها إلى صفحاتٍ لم يرها من قبل، فتتّسع دائرة ما يعرفه من الويب يومًا بعد يوم. وتقول جوجل إنّ الغالبية العظمى من الصفحات في نتائجها لم يقدّمها أحدٌ يدويًّا، بل وجدها الزاحف وحده وهو يتنقّل بين الروابط.[2]
من هنا تفهم لماذا تهمّ الروابط الداخلية، فالصفحة التي لا يشير إليها أيّ رابطٍ في موقعك صفحةٌ «يتيمة»، ولا طريق إليها إلّا أن يعرف الزاحف عنوانها من مكانٍ آخر. وخريطة الموقع (Sitemap) تسدّ جزءًا من هذه الثغرة، لأنّها قائمةٌ بصفحاتك تسلّمها لجوجل دفعةً واحدة، لكنّها لا تعوّض رابطًا حقيقيًّا يصل إلى الصفحة من داخل الموقع.
والزاحف لا يدخل كلّ ما اكتشفه. بعض الصفحات يمنعه صاحب الموقع منها في ملفّ robots.txt، وبعضها لا يُفتح إلّا بتسجيل دخول، وهو مبرمجٌ أيضًا ألّا يثقل على خادمك: يقرأ استجابات الموقع، فإذا تكرّرت أخطاء 500 فهم أنّ عليه أن يبطئ.[2] فالخادم البطيء أو المتعثّر يعني زيارةً أقلّ وصفحاتٍ أقلّ تُقرأ.
وأوّل ما يقرؤه الزاحف من كلّ صفحةٍ رمز الاستجابة (HTTP status code)، وعليه يتوقّف ما يحدث بعده. الرمز 200 يعني أنّ المحتوى وصل، فيصير مرشّحًا للفهرسة من غير ضمان. ورموز العائلة 4xx، مثل 404 و410، تعني أنّ الصفحة غير موجودة، فلا يفهرسها جوجل، وإن كانت مفهرسةً من قبل أخرجها من الفهرس. أمّا رموز 5xx والرمز 429 فيعدّها أخطاء خادم، فيبطئ الزحف مؤقّتًا، ويُبقي الصفحات المفهرسة في مكانها مدّةً ثمّ يسقطها في النهاية إن استمرّ الخطأ.[3] فالخادم الذي يتعثّر أسابيع قد يكلّفك صفحاتٍ كانت في الفهرس.
ولا يزور الزاحف صفحتك مرّةً ثمّ ينساها. يعود إليها ليلتقط ما تغيّر، ويتفاوت ذلك بحسب شعبية الصفحة وحاجتها إلى التجديد. فالصفحات الأكثر شعبيةً على الإنترنت تُزحَف أكثر، والصفحة التي تتغيّر كثيرًا يُعاد إليها أسرع من صفحةٍ لم تُلمَس منذ سنة.[4] فإن حدّثت مقالًا مهمًّا فلا تحكم على أثر التحديث بعد ساعة، وامنح الزاحف وقته ليعود.
ويقلق كثيرون من «ميزانية الزحف» (Crawl budget)، أي عدد الصفحات التي يزحفها جوجل من موقعك في مدّةٍ ما. ودليل جوجل عنها يحدّد لمن كُتب. أوّلًا المواقع الكبيرة التي تتجاوز مليون صفحةٍ ويتغيّر محتواها أسبوعيًّا، ثمّ المواقع التي تبدأ من عشرة آلاف صفحةٍ إذا تغيّر محتواها يوميًّا. وأخيرًا المواقع التي يصنّف Search Console جزءًا كبيرًا من روابطها في حالة Discovered – currently not indexed، أي اكتُشفت ولم تُفهرَس.[4] إن لم يكن موقعك واحدًا من هؤلاء، فهذا الموضوع ليس مشكلتك، ووقتك أنفع في جودة ما تنشره.
التصيير: حين تكون الصفحة شيفرةً قبل أن تكون نصًّا
كثيرٌ من المواقع اليوم تُبنى بأطر JavaScript ترسل إلى المتصفّح صفحةً شبه فارغة، ثمّ تبني الشيفرة محتواها أمام الزائر. ولكي يرى جوجل ما يراه الزائر، يضع كلّ صفحةٍ تعيد الرمز 200 في طابور «التصيير» (Rendering)، ثمّ يشغّل نسخةً من متصفّح كروم بلا واجهة تنفّذ الشيفرة. وتقول جوجل إنّ الصفحة قد تبقى في هذا الطابور بضع ثوانٍ، وقد تبقى أطول، بحسب ما تسمح به مواردها. وإن حجبت ملفّات JavaScript نفسها في robots.txt، فلن يستطيع جوجل تنفيذها أصلًا.[5]
والدرس لمن يبني تطبيقات الصفحة الواحدة (SPA) واضح. إن كان محتواك المهمّ لا يظهر إلّا بعد تنفيذ الشيفرة، فأنت تراهن على أن ينجح التصيير في كلّ مرّة. الأسلم أن يصل المحتوى الأساسيّ في HTML الأوّل، بالعرض من الخادم أو بالتوليد المسبق، وهما خياران تشرحهما مقالة أطر جافاسكربت في سلسلة تطوير الويب.
المرحلة الثانية: الفهرسة
بعد أن يزحف جوجل إلى صفحةٍ ويصيّرها، يحاول أن يفهمها. يقرأ نصّها ووسومها المهمّة، كالعنوان والنصّ البديل للصور، ويحدّد موضوعها والكيانات التي تتحدّث عنها من أشخاصٍ وأماكن وأشياء، ثمّ يخزّن ما فهمه في الفهرس. والفهرس في جوهره يشبه الفهرس في آخر كتاب: كلّ كلمةٍ أو مفهومٍ مربوطٌ بالصفحات التي تتناوله، لكن بمقياس مئات المليارات من الصفحات.
وهذا الفهرس ليس شيئًا مجرّدًا، فهو بياناتٌ مخزّنةٌ على خوادم حقيقية في مبانٍ حقيقية، موزّعةٍ على مراكز بيانات جوجل حول العالم، مثل المركز الذي في الصورة.

والنقطة التي يغفلها كثيرون أنّ الفهرسة ليست مضمونة. قد يزحف جوجل إلى صفحتك ثمّ يقرّر أنّها مكرّرة أو ضعيفة القيمة فيتركها خارج الفهرس. وتراها عندئذٍ في تقرير فهرسة الصفحات في Search Console بحالاتٍ مثل Crawled – currently not indexed، أي زُحفت ولم تُفهرَس.[6] فشرط الترتيب أن تُفهرَس الصفحة أوّلًا، وشرط الفهرسة أن يكون فيها ما يستحقّ مكانًا.
والفهرسة اليوم تقوم على نسخة الجوّال. جوجل يستعمل ما يراه زاحف الهواتف الذكية من محتوى موقعك للفهرسة والترتيب. وقد أعلن في 3 حزيران 2024 آخر خطوةٍ في هذا الانتقال: بعد 5 تموز 2024 صار يزحف حتى إلى المواقع القليلة الباقية بزاحف الهواتف وحده.[7] فإن كانت نسخة الجوّال من موقعك تُخفي جزءًا من المحتوى أو تختصره، فذلك الجزء غير موجودٍ في نظر جوجل.
ثمّ تأتي مسألة النسخ المكرّرة، فلنفترض أنّ منتجًا في متجرك يُوصَل إليه بثلاثة روابط: من قائمة الأحذية، ومن صفحة العروض، ومن رابطٍ فيه معاملات تتبّعٍ بعد علامة الاستفهام. المحتوى واحد والروابط ثلاثة، ولو فهرسها جوجل كلّها لتنافست صفحتك مع نفسها. لذلك يجمعها ويختار واحدًا يسمّيه «الرابط الأساسيّ» (Canonical) ويعرضه وحده.
وأنت تستطيع أن تعينه على هذا الاختيار. تذكر جوجل وسائل ذلك مرتّبةً بقوّة أثرها: التحويل إلى الرابط الذي تريده إشارةٌ قويّة، ووسم rel="canonical" إشارةٌ قويّة، وإدراج الرابط في خريطة الموقع إشارةٌ ضعيفة.[8] ولاحظ كلمة «إشارة»: جوجل يأخذ اختيارك في حسابه، وقد يختار غيره إن رأى إشارات أخرى أقوى. ومن هنا حالةٌ يضع فيها Search Console بعض صفحاتك، اسمها Alternate page with proper canonical tag، أي صفحةٌ بديلةٌ تشير إلى رابطها الأساسيّ. وهذه في الغالب علامةٌ على أنّ التوحيد يعمل كما أردت.
المرحلة الثالثة: التقديم والترتيب
حين تكتب سؤالك، يفتّش جوجل فهرسه عن الصفحات المناسبة ويرتّبها في جزءٍ من ثانية. وتصف جوجل ما تنظر إليه في الترتيب بخمس مجموعاتٍ من الإشارات: معنى السؤال، أي ما الذي تقصده فعلًا؛ وصلة المحتوى بما تقصده؛ وجودة المحتوى؛ وقابلية استعمال الصفحة، ومنها أن تعمل جيّدًا على الجوّال وتُحمَّل بسرعة؛ والسياق، ومنه موقعك الجغرافيّ ولغتك وإعداداتك.[9] ويختلف وزن كلّ مجموعةٍ من سؤالٍ إلى آخر، فالأخبار الجارية مثلًا تُقدَّم فيها الصفحة الأحدث، والتعريف القاموسيّ لا يحتاج ذلك.
وأوّل هذه المجموعات أعمق ممّا يبدو. تقول جوجل إنّها تبني نماذج لغويةً لتفهم كيف تطابق الكلمات القليلة التي تكتبها المحتوى الأنفع.[9] فهي تصحّح أخطاءك الإملائية، وتعرف أنّ «كيف أسرّع موقعي» و«تحسين سرعة الصفحة» سؤالٌ واحد، وتميّز من يريد تعريفًا ممّن يريد أن يشتري. ولهذا أثرٌ مباشرٌ على كتابتك: اكتب بلغةٍ طبيعيةٍ تغطّي الموضوع، ولا تكرّر عبارةً مفتاحيةً بحرفها في كلّ فقرة، فالمحرّك يقرأ المعنى.
وهنا أصحّح رقمًا يتردّد كثيرًا في المحتوى العربيّ: «جوجل يعتمد 200 عامل ترتيب». في 27 أيلول 2021 قال جون مولر من جوجل إنّهم ابتعدوا عن هذا الرقم، لأنّ مجرّد وجود رقمٍ كهذا «مضلّل» في رأيه، إذ يصعب فصل الإشارات بعضها عن بعض.[10] فلا تبحث عن قائمة من مئتي بندٍ لتؤدّيها واحدًا واحدًا، واعمل على المجموعات الخمس.
والجودة وقابلية الاستعمال تختلطان على كثيرين. الجودة تسأل: هل هذا المحتوى نافعٌ وموثوقٌ من مصدرٍ ذي خبرة؟ وهنا يدخل إطار E-E-A-T بوصفه طريقةً في التفكير بالجودة لا مقياسًا رقميًّا. وقابلية الاستعمال تسأل سؤالًا آخر: بين صفحتين متقاربتين في الجودة والصلة، أيّهما أسرع وأثبت على الجوّال؟ فالسرعة قد تفصل بين متقاربين، لكنّها لا ترفع محتوًى ضعيفًا، وهذا ما يشرحه مقال مؤشّرات أداء الويب الأساسية.
ولا يوجد ترتيبٌ واحدٌ يراه الجميع. من يكتب «مطعم مشاوي» في الرياض يرى غير ما يراه من يكتبه في دمشق أو في برلين، ومن يبحث بالعربية يرى غير ما يراه من يبحث بالإنجليزية. لذلك حين تبحث عن كلمتك لترى ترتيبك، فأنت ترى نسختك أنت، والرقم الأصدق لترتيبك عند جمهورك كلّه هو ما يعرضه Search Console.
وقد تغيّر الترتيب نفسه في السنوات الأخيرة. نظام «المحتوى المفيد» الذي أعلنته جوجل سنة 2022 صار في آذار 2024 جزءًا من أنظمة الترتيب الأساسية،[11] فصار سؤال «هل كُتبت هذه الصفحة لإنسان؟» حاضرًا في كلّ ترتيبٍ لا في تحديثٍ منفصل. وتغيّرت صفحة النتائج كذلك: فوق الروابط في كثيرٍ من الأسئلة الآن «نظرةٌ عامة بالذكاء الاصطناعي» تركّب جوابًا من عدّة صفحات، وصارت متاحةً بالعربية منذ 20 أيار 2025.[12] وقد رسمتُ طبقات صفحة النتائج كلّها في المقال الأوّل من السلسلة، ولأثر الذكاء الاصطناعي فيها مقالٌ مستقلّ.
كيف يكلّم موقعك محرّك البحث
العلاقة بين موقعك والمحرّك ليست من طرفٍ واحد، فلديك أدواتٌ ترشده بها، ولكلّ أداةٍ مرحلةٌ تعمل فيها. ملفّ robots.txt يعمل في مرحلة الزحف، فيقول للزاحف أيّ المسارات يدخل وأيّها يتركه. وخريطة الموقع تعين على الاكتشاف. ووسم noindex، في رأس الصفحة أو في ترويسة الاستجابة، يعمل في مرحلة الفهرسة فيطلب إخراج الصفحة من النتائج. ووسم canonical يوحّد النسخ المكرّرة. والبيانات المنظّمة (Schema) تشرح نوع محتواك ليُعرَض عرضًا أوضح.
وأكثر ما يُخلط بينه أداتان: الحجب في robots.txt ووسم noindex. تقول جوجل صراحةً إنّ robots.txt ليس وسيلةً لإبعاد صفحةٍ عن نتائجها، فالصفحة المحجوبة قد يظهر رابطها في النتائج بلا وصف، إن أشارت إليها صفحاتٌ أخرى.[13] أمّا noindex فيُخرج الصفحة من النتائج مهما ربطت إليها مواقع أخرى، بشرطٍ واحد: أن يستطيع الزاحف قراءة الصفحة. فإن حجبتها في robots.txt أيضًا، فلن يرى الزاحف الوسم أبدًا.[14] والشكل 2 يضع المسارين جنبًا إلى جنب.
والخلاصة العملية: إن أردت إبعاد صفحةٍ عن نتائج جوجل، فاتركها مفتوحةً للزاحف وضع فيها noindex، أو احمها بكلمة مرور. واستعمل robots.txt لغرضه الأصليّ، وهو إبعاد الزاحف عن مساراتٍ لا فائدة من زحفها، كنتائج البحث الداخليّ أو صفحات الفرز التي لا تنتهي.
جوجل ومن حوله
في آب 2026 كانت حصّة جوجل من البحث في العالم 91.1% بحسب StatCounter، يليه Bing بـ4.5%، ثمّ Yahoo وYandex وDuckDuckGo وBaidu، وكلٌّ منها تحت 1.3%.[15] وفي أسواقنا العربية تكاد الحصّة تكتمل، فقد تجاوزت 95% في السعودية والإمارات ومصر وبلغت 98.22% في سوريا في الشهر نفسه، كما في المقال الأوّل. ولهذا تدور هذه السلسلة حول جوجل.
لكنّ Bing أهمّ من حصّته، فمحرّك DuckDuckGo يقول في صفحة مساعدته إنّ روابطه وصوره التقليدية مأخوذةٌ في معظمها من Bing، إلى جانب زاحفه الخاصّ ومصادر أخرى.[16] وصفحة مساعدة OpenAI تقول إنّ بحث ChatGPT قد يرسل استعلاماتٍ مجرّدةً من هويّة المستخدم إلى محرّك Bing ليعيد نتائج من الويب.[17] فظهورك في فهرس Bing لا يعني زوّاره وحدهم، ويمتدّ إلى مساعداتٍ يسألها الناس بدل محرّك البحث.
وكلّ هذه المحرّكات تتبع المنطق نفسه: اكتشافٌ ثمّ فهرسةٌ ثمّ ترتيب، وتختلف في حجم فهارسها وفي الإشارات التي تقدّمها وفي قدرتها على تنفيذ JavaScript. فمن فهم المبادئ لجوجل فهمها لغيره، ولا يحتاج إلّا تعديلاتٍ صغيرة. وللمحرّكات الإقليمية شأنها، كـYandex في روسيا وBaidu في الصين، لكنّ جمهورك في الخليج وسوريا وأوروبا وأمريكا الشمالية يبحث غالبًا في جوجل.
خرافاتٌ عن طريقة عمل المحرّك
- «يجب أن تقدّم موقعك لجوجل ليعرفه»: جوجل يكتشف الغالبية العظمى من الصفحات بنفسه عبر الروابط، كما مرّ. خريطة الموقع وSearch Console يسرّعان الاكتشاف، وليسا شرطًا له.
- «جوجل يفهرس كلّ صفحة يزورها»: الفهرسة انتقائية، وجوجل نفسها لا تضمنها لأيّ صفحة.
- «الدفع لجوجل يسرّع الزحف أو يرفع الترتيب»: تقول جوجل في دليلها إنّها لا تقبل مالًا لتزحف إلى موقعٍ أكثر أو ترتّبه أعلى، ومن يقل غير ذلك مخطئ.[2]
- «وسم الكلمات المفتاحية يرفع ترتيبك»: أعلنت جوجل في أيلول 2009 أنّها لا تستعمل وسم meta keywords في الترتيب.[18]
- «الصفحة التي زُحفت ستظهر في النتائج»: الزحف غير الفهرسة، والفهرسة غير الترتيب، وفي كلّ مرحلةٍ قد تتوقّف الصفحة.
لماذا لا تظهر صفحتك الجديدة فورًا؟
هذا السؤال يقلق كلّ من ينشر أوّل مرّة: «نشرت صفحةً ممتازة، فلماذا لا أجدها في جوجل؟». والجواب أنّ الصفحة تحتاج أن تقطع المراحل الثلاث كلّها. عليها أن يكتشفها الزاحف أوّلًا، وقد يمضي وقتٌ قبل أن يصل إليها. ثمّ أن يراها جوجل جديرةً بالفهرس، ثمّ أن تكسب ما يكفي من الصلة والجودة لتتقدّم على صفحاتٍ سبقتها إلى المكان بسنوات، وهذه أبطأ المراحل كلّها.
وهذا الفهم يحميك من خطأين معًا. الأوّل قلقٌ في غير موضعه، كمن يقلق من ميزانية الزحف وموقعه خمسون صفحة. والثاني طمأنينةٌ في غير موضعها، كمن يظنّ أنّ صفحته مفهرسة وهي خارج الفهرس منذ أشهر. فابدأ دائمًا من الأساس: تحقّق أنّ صفحاتك المهمّة تُزحَف وتُفهرَس، وإلّا فكلّ عملٍ على الترتيب بعد ذلك يضيع.
افحص المراحل الثلاث على موقعك
ابدأ بالمعامل site: في جوجل: اكتب site: ثمّ نطاق موقعك، فتظهر لك عيّنةٌ من صفحاته المفهرسة. ولا تعدّ النتائج لتعرف حجم فهرستك، فجوجل تقول إنّ هذا المعامل لا يعرض بالضرورة كلّ الروابط المفهرسة، وتنصح بأداة فحص الرابط بدلًا منه.[19] فافتح Search Console، والصق رابط صفحةٍ نشرتها حديثًا في أداة فحص الرابط، فتعرف منها هل زحف إليها جوجل، وهل فُهرست، وهل فيها ما يمنع ذلك.
ثمّ افحص الصفحة نفسها من الداخل. إضافة Full SEO Page Analyzer التي بنيتُها لمتصفّح كروم تعرض لك في نافذةٍ واحدة ما يهمّ هذه المراحل. فيها وسم الروبوتات في الصفحة، ومنه أيّ noindex منسيّ، والرابط الأساسيّ الذي تعلنه الصفحة لنفسها، وسلسلة التحويلات التي يمرّ بها الزاحف حتى يصل، ورمز الاستجابة الأخير. وإن اختلف ما تعلنه الصفحة عمّا يقوله Search Console، فعندك خيطٌ تتبعه.
وأخيرًا، ابحث عن موضوعٍ تعرفه جيّدًا وتأمّل صفحة النتائج بعين المحرّك. هل في الأعلى نظرةٌ عامة بالذكاء الاصطناعي؟ ما أنواع النتائج التي اختارها جوجل: مقالات، أم فيديو، أم خريطة؟ ومن تصدّر، ولماذا في رأيك: لأنّه موقعٌ ذو سمعة، أم لأنّ جوابه أدقّ وأقرب إلى ما سألت؟ وهذا التمرين يدرّبك على رؤية المرحلة الثالثة وهي تعمل.
خلاصة عملية
- جوجل يبحث في فهرسٍ بناه مسبقًا، والصفحة تمرّ قبل ظهورها بثلاث مراحل: زحفٍ ففهرسةٍ فتقديم، وقد تتوقّف عند أيٍّ منها.
- اربط كلّ صفحةٍ مهمّة من داخل موقعك، ولا تترك الاكتشاف لخريطة الموقع وحدها.
- ضع المحتوى الأساسيّ في HTML الأوّل إن كان موقعك مبنيًّا بإطار JavaScript.
- لإخراج صفحةٍ من النتائج استعمل noindex على صفحةٍ مفتوحةٍ للزاحف، ولا تحجبها في robots.txt.
- ميزانية الزحف تخصّ المواقع الكبيرة أو السريعة التغيّر؛ إن لم يكن موقعك منها فاصرف جهدك في الجودة.
- تحقّق من الفهرسة بأداة فحص الرابط في Search Console، لا بعدّ نتائج site:.
وقبل أن تحسّن صفحةً لتُزحَف وتُفهرَس وتُرتَّب، عليك أن تعرف أيّ سؤالٍ تريدها أن تجيب عنه، وبأيّ كلماتٍ يطرحه جمهورك، وذلك موضوع المقال التالي، بحث الكلمات المفتاحية ونيّة البحث.
المصادر
- جوجل، صفحة «Organizing information» من سلسلة «كيف يعمل البحث»: الفهرس يغطّي مئات المليارات من الصفحات ويتجاوز 100,000,000 جيجابايت.
- جوجل، مركز البحث للمطوّرين، «In-depth guide to how Google Search works» (آخر تحديث 18 كانون الأوّل 2025): المراحل الثلاث، وأنّ الصفحات لا تعبرها كلّها ولا ضمان للزحف أو الفهرسة أو العرض، وأنّ الغالبية العظمى من الصفحات تُكتشف تلقائيًّا، وأنّ الزاحف يبطئ عند أخطاء 500، وأنّ جوجل لا تقبل مالًا لتزحف أكثر أو ترتّب أعلى.
- جوجل، وثائق الزحف، «How HTTP status codes affect Google’s crawlers» (آخر تحديث 4 شباط 2026): رموز 4xx تُخرج الرابط من الفهرس، ورموز 5xx و429 تبطئ الزحف وتُسقط الروابط المفهرسة في النهاية.
- جوجل، مركز البحث للمطوّرين، «Crawl budget management» (آخر تحديث 22 تموز 2026): لمن كُتب الدليل (مليون صفحة فأكثر تتغيّر أسبوعيًّا، أو عشرة آلاف فأكثر تتغيّر يوميًّا، أو كثرة Discovered – currently not indexed)، وأنّ الروابط الأكثر شعبيةً تُزحَف أكثر.
- جوجل، مركز البحث للمطوّرين، «Understand the JavaScript SEO basics» (آخر تحديث 4 آذار 2026): طابور التصيير لكلّ صفحةٍ تعيد 200، وبقاء الصفحة فيه ثوانيَ أو أطول، والتصيير بمتصفّح Chromium بلا واجهة، وأنّ جوجل لا يصيّر JavaScript من ملفّاتٍ محجوبة.
- مساعدة Search Console، «Page indexing report»: حالات الفهرسة، ومنها Crawled – currently not indexed وAlternate page with proper canonical tag.
- مدوّنة مركز البحث من جوجل، «Mobile-indexing vLast final final.doc»، 3 حزيران 2024: الخطوة الأخيرة من الانتقال إلى الفهرسة بنسخة الجوّال بعد 5 تموز 2024.
- جوجل، مركز البحث للمطوّرين، «How to specify a canonical URL» (آخر تحديث 10 تموز 2026): التحويل وrel=canonical إشارتان قويّتان، والإدراج في خريطة الموقع إشارةٌ ضعيفة.
- جوجل، صفحة «Ranking results» من سلسلة «كيف يعمل البحث»: إشارات المعنى والصلة والجودة وقابلية الاستعمال والسياق، والنماذج اللغوية لفهم السؤال.
- باري شوارتز، Search Engine Roundtable، «Google: 200 Ranking Signals Figure Is Misleading»، ينقل كلام جون مولر من جوجل في بثّ 27 أيلول 2021.
- جوجل، مركز البحث للمطوّرين، «A guide to Google Search ranking systems»: نظام المحتوى المفيد أُعلن سنة 2022 ودُمج في الأنظمة الأساسية في آذار 2024.
- مدوّنة جوجل للشرق الأوسط وشمال أفريقيا، «Bringing AI Overviews to MENA, and in Arabic globally»، 20 أيار 2025.
- جوجل، مركز البحث للمطوّرين، «Introduction to robots.txt» (آخر تحديث 10 كانون الأوّل 2025): robots.txt ليس وسيلةً لإبعاد صفحةٍ عن جوجل، والصفحة المحجوبة قد يظهر رابطها بلا وصف.
- جوجل، مركز البحث للمطوّرين، «Block Search indexing with noindex»: noindex يُخرج الصفحة مهما ربطت إليها مواقع أخرى، ويلزم ألّا تكون محجوبةً في robots.txt وإلّا فلن يرى الزاحف الوسم.
- موقع StatCounter Global Stats، حصص محرّكات البحث لشهر آب 2026: «العالم» (جوجل 91.1%، Bing 4.5%، Yahoo 1.23%، Yandex 0.99%، DuckDuckGo 0.7%، Baidu 0.62%)، و«السعودية» و«الإمارات» و«مصر» و«سوريا»، اطُّلع عليها في 25 أيلول 2026.
- مساعدة DuckDuckGo، «Where do DuckDuckGo search results come from?»: الروابط والصور التقليدية مأخوذةٌ في معظمها من Bing، إلى جانب زاحفه DuckDuckBot.
- مركز مساعدة OpenAI، «ChatGPT search for Enterprise and Edu»: بحث ChatGPT قد يرسل استعلاماتٍ مجرّدةً من هويّة المستخدم إلى Bing ليعيد نتائج الويب، اطُّلع عليها في 25 أيلول 2026.
- مدوّنة مركز البحث من جوجل، «Google does not use the keywords meta tag in web ranking»، أيلول 2009.
- جوجل، مركز البحث للمطوّرين، «site: search operator»: المعامل لا يعرض بالضرورة كلّ الروابط المفهرسة، ولفحص رابطٍ بعينه تُستعمل أداة فحص الرابط.